
Un token en IA es la unidad mínima en la que un modelo parte un texto para poder procesarlo. Puede ser una palabra entera, un trozo de palabra, un signo de puntuación o un espacio.
Los tokens importan por dos motivos distintos: son la unidad con la que se mide el uso de un modelo y son la unidad con la que se mide cuánto texto puede tener delante a la vez.
¿Qué son los tokens en IA?
Los tokens en IA son las piezas en que un modelo descompone el lenguaje antes de trabajar con él, y de las que calcula cuál viene después.
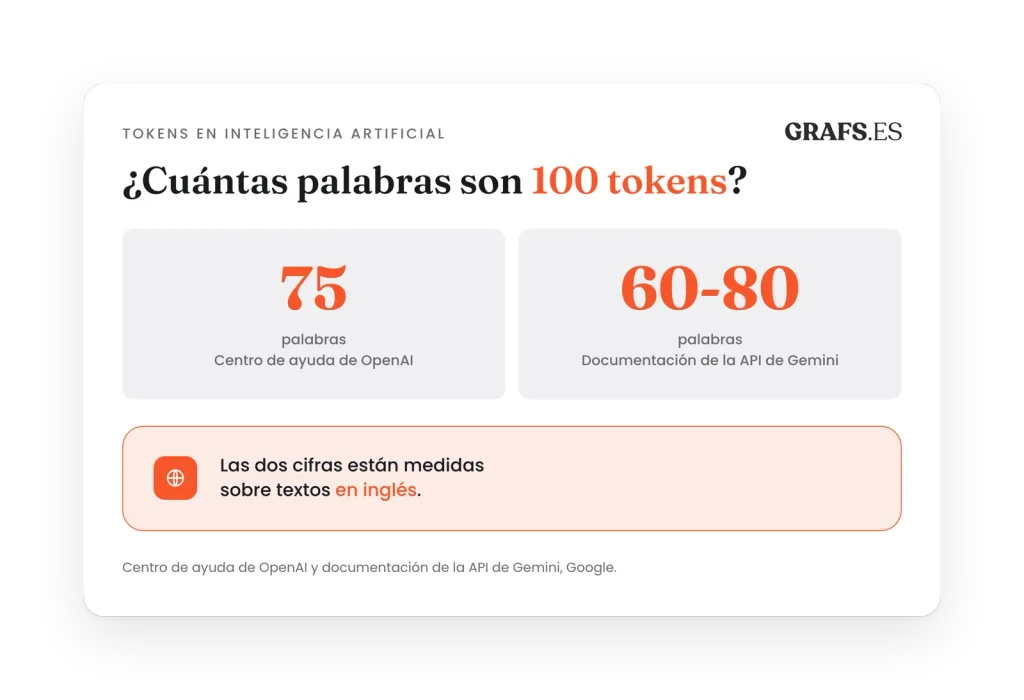
Según el centro de ayuda de OpenAI, un token son unos 4 caracteres, aproximadamente tres cuartos de palabra, y 100 tokens equivalen a unas 75 palabras.
Sin embargo, esas cifras vienen bajo un epígrafe que dice «Usar estimaciones aproximadas para textos en inglés».
Google, en cambio, da otro número. En la documentación de la API de Gemini aparece un rango en lugar de una cifra: «100 tokens equivalen a entre 60 y 80 palabras en inglés».
El tokenizador: herramienta para conocer el número de tokens
El mismo texto vale distintos tokens según el modelo que lo lea o el idioma en el que está escrito.
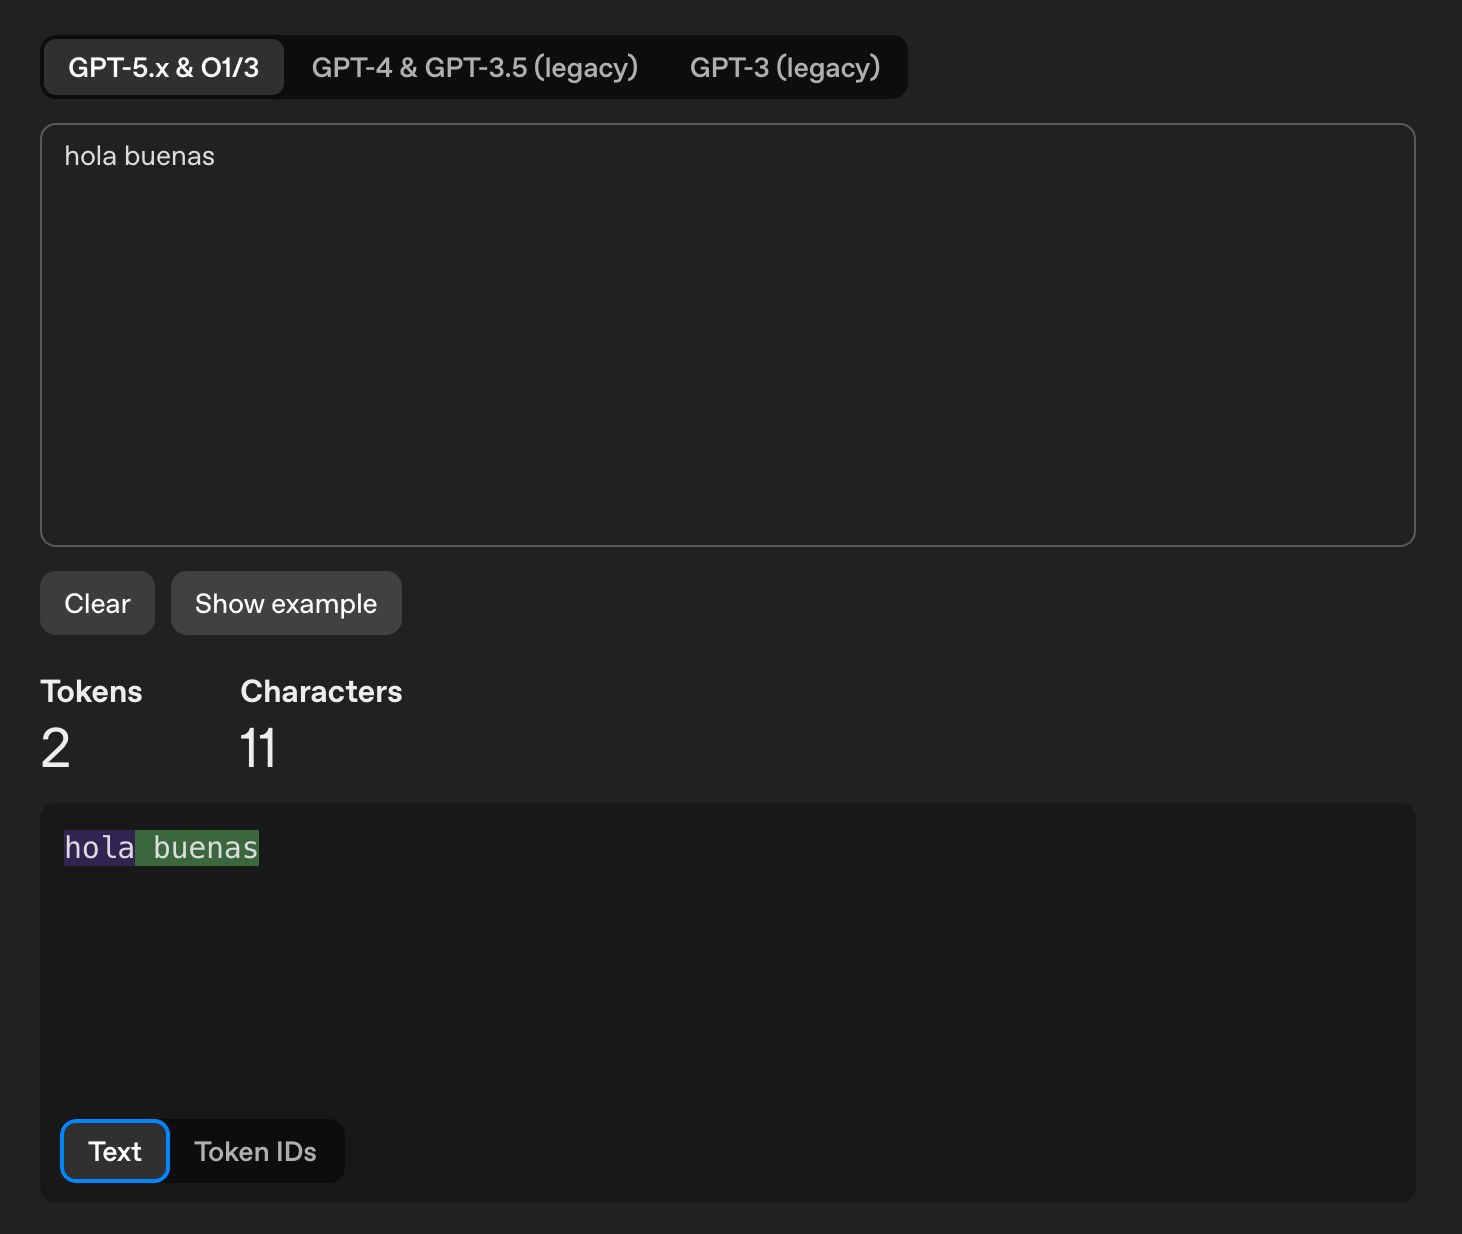
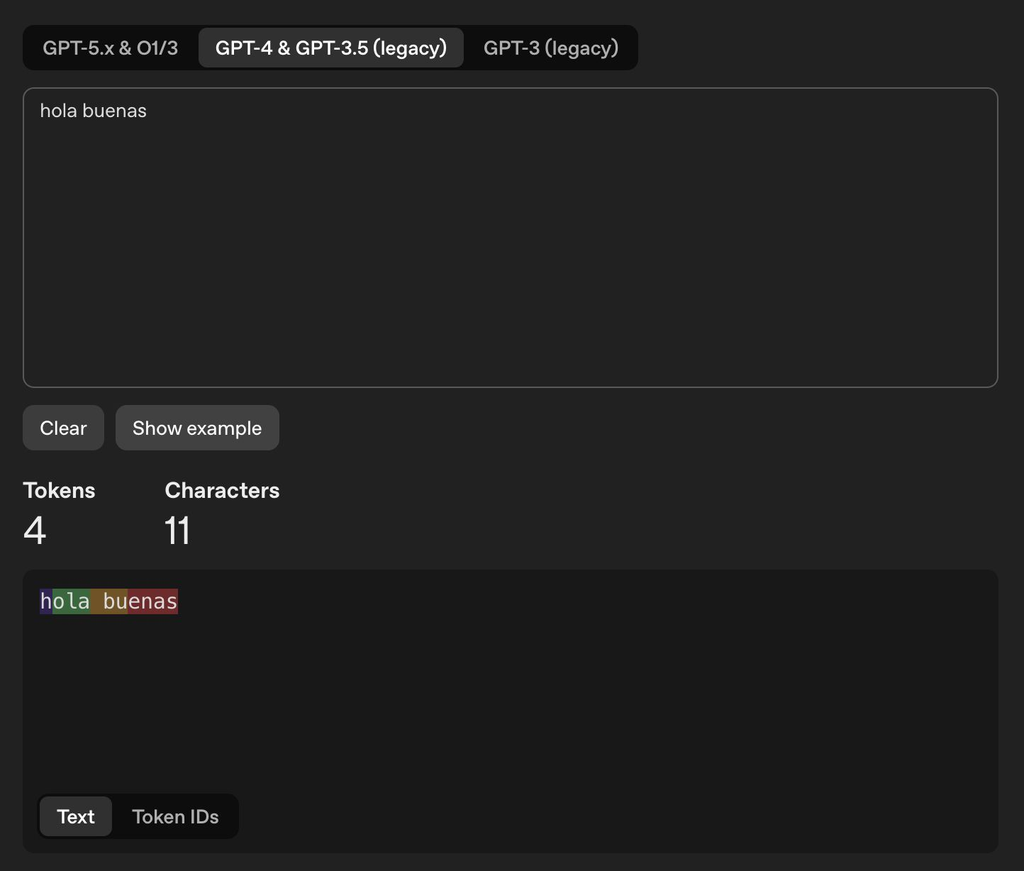
Para comprobarlo, existen herramientas como el tokenizador que publica OpenAI, que separa las generaciones en pestañas. Un saludo como «hola buenas» ocupa 2 tokens en la pestaña de GPT-5.x y 4 en la de GPT-4, que lo parte en «h», «ola», « bu» y «enas».
Para demostrar la diferencia de tokens en idiomas, pondremos un ejemplo: sobre los diez primeros artículos de la Declaración Universal de Derechos Humanos, en las versiones oficiales que publica Naciones Unidas en los dos idiomas, el español ocupa un 46 % más de tokens que el inglés en la pestaña de GPT-4, y un 24 % más en la de GPT-5.x.
Con un texto administrativo de 48 palabras, en cambio, el sobrecoste es bastante menor: un 20 % en la pestaña de GPT-4 y un 12 % en la de GPT-5.x.
¿Cómo funcionan los tokens en una IA?
Los tokens funcionan en dos planos que se cuentan por separado.
Uso: los tokens que entran y los que salen
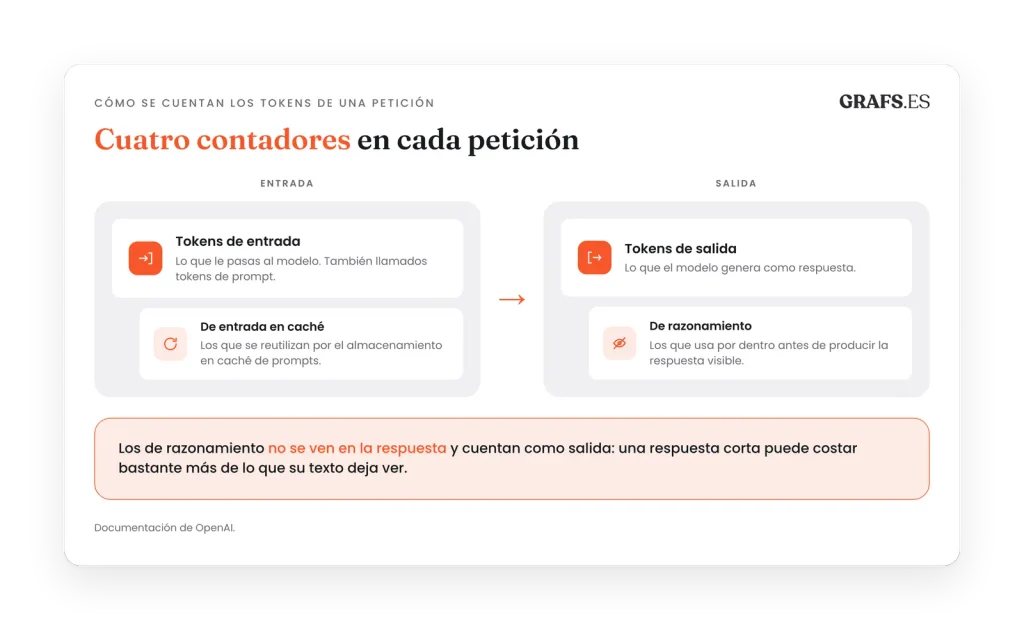
Cada vez que se lanza una petición, el modelo cuenta los tokens que entran y los que salen. La documentación de OpenAI los reparte en dos contadores, con un caso particular dentro de cada uno:
- Tokens de entrada: los que se le pasan al modelo en la petición, también llamados tokens de prompt.
- De entrada en caché: los que se reutilizan mediante el almacenamiento en caché de prompts.
- Tokens de salida: los que genera el modelo.
- De razonamiento: los que un modelo de razonamiento usa internamente antes de producir su respuesta visible.
Los de razonamiento no se muestran en la respuesta y cuentan como salida, así que una respuesta corta puede consumir bastante más de lo que su texto deja ver.
El consumo de la cuenta se ve en el panel de uso de OpenAI.
Contexto: los tokens que caben a la vez
La ventana de contexto es el tope de tokens que un modelo puede manejar en una misma petición. Dentro entran las instrucciones, los documentos que se le pasen, la conversación anterior y la respuesta que va a escribir.
Cuando la conversación se acerca a ese tope, cada sistema lo resuelve a su manera.
Claude Code, por poner un caso documentado, lo resuelve con una compactación automática que resume el historial al acercarse al límite, y deja además el comando /compact para hacerlo a mano señalando qué conservar.
El uso se acumula petición a petición y tiene o no techo, en función del plan o si está conectado por API y el dinero que se está dispuesto a invertir. En cambio, el contexto se agota dentro de una sola sesión y se recupera al empezar otra.
Elegir modelo y plan según los tokens que va a consumir cada tarea es una de las decisiones que se toman en una consultoría de IA, antes de conectar nada.
¿Cuántos tokens admite cada modelo de IA?
El «millón de tokens» de Gemini son 1.048.576, que es 2²⁰ exacto, y así viene publicado en la ficha de cada modelo.
Estos son los límites de las tres casas, leídos el 14 de septiembre de 2026 en la ficha de cada fabricante.
| Modelo | Ventana de contexto | Salida máxima |
|---|---|---|
| GPT-6 Astra · GPT-5.6 Sol, Terra y Luna | 1,05 millones | 128.000 |
| Gemini 3.1 Pro (preview), 3.6 Flash, 3.5 Flash, 3.5 Flash-Lite, 2.5 Pro, 2.5 Flash y 2.5 Flash-Lite | 1.048.576 | 65.536 |
| Claude Fable 5.1, Opus 5 y Sonnet 5 | 1.000.000 | 128.000 |
| Claude Haiku 4.5 | 200.000 | 64.000 |
Otro detalle que enseña la tabla es que la ventana no acompaña necesariamente al tamaño del modelo ni a la posición que ocupa en su gama.
En Anthropic, Sonnet 5 y Fable 5.1 tienen la misma ventana de un millón de tokens. En Google, además, del Pro al Flash-Lite los siete modelos publican el mismo límite.
El millón de tokens: cuántas palabras son
La única que publica la equivalencia del millón de tokens es Anthropic, en su comparativa de modelos: un millón de tokens son unas 555.000 palabras con su tokenizador actual, frente a unas 750.000 con los anteriores.
Como cada fabricante cuenta con su propio vocabulario, la equivalencia en palabras solo se puede comparar entre modelos de la misma casa.
¿Qué es la tokenización?
La tokenización es el proceso por el que un texto se convierte en la lista de tokens que el modelo puede procesar.
El texto se normaliza y se parte en unidades según el vocabulario del tokenizador con el que se entrenó el modelo. Cada unidad recibe después un identificador numérico.
Preguntas frecuentes
¿Qué significa «tokens» en IA?
Significa las unidades mínimas en las que un modelo divide un texto para procesarlo. Una palabra larga puede partirse en dos o más tokens, y la puntuación y los espacios también cuentan. Para saber cuántos lleva un texto concreto, el tokenizador de OpenAI lo resuelve pegándolo en la caja.
¿Cuánto son 1.000.000 de tokens en IA?
Depende del tokenizador. Anthropic publica unas 555.000 palabras para el suyo actual y unas 750.000 para los anteriores, y es la única que da la equivalencia del millón. Como cada fabricante cuenta con su propio vocabulario, la comparación válida es entre modelos de la misma casa.
¿Qué IA tiene más tokens?
En septiembre de 2026 la ventana está igualada arriba: OpenAI publica 1,05 millones en su familia GPT-5.6 y GPT-6, Google 1.048.576 en los siete modelos Gemini y Anthropic un millón en Fable 5.1, Opus 5 y Sonnet 5. La diferencia está en la salida máxima, donde OpenAI y Anthropic publican 128.000 tokens y Google 65.536. El número que decide es el de la ficha del modelo concreto, porque puede cambiar de una versión a otra.
¿Qué es un token en ChatGPT?
Es la misma pieza que en cualquier otro modelo. Lo particular de ChatGPT es que OpenAI publica su tokenizador, así que el reparto exacto de un texto se puede comprobar antes de enviarlo.
¿Qué son los tokens en Claude?
Los tokens en Claude se cuentan con otro vocabulario, que es la razón de que el mismo texto dé cifras distintas. Anthropic lo declara en su documentación: el tokenizador que estrenó con Claude Opus 4.7 mete unas 555.000 palabras en un millón de tokens, frente a las 750.000 de los modelos anteriores. Al comparar dos modelos de casas distintas, la ventana se mide en tokens y las palabras se calculan aparte para cada uno.
